ポートフォリオのリスク分析(標準偏差・相関)
Python経験者向けの投資分析シリーズ(全15回)の最終回。第14回で貯めた終値から、日次リターンの散らばり(標準偏差)と銘柄同士の連動(相関係数)を数値にします。pandasとNumPyで std() の答えが変わる理由、√252 が置いている仮定、重なる日が2日だと相関が 1.00 になる罠——数字が出るからこそ危ない場所を実測で並べます。
- 1. この記事のゴールと、ここでいう「リスク」の意味
- 2. 入力をそろえる — 貯めたDBを「日付 × 銘柄」の表にする
- 3. つまずき実演①:dropna() で7割の日が消え、相関が 1.00 になった
- 4. 日次リターンにする — 単純・対数と、pandas 3.0 の pct_change
- 5. つまずき実演②:同じデータなのに pandas と NumPy で標準偏差が違う
- 6. 年率に直す(年率ボラティリティ)— なぜ √252 なのか、252 はどこから来たのか
- 7. 相関行列のヒートマップを、seaborn なしで matplotlib(imshow)だけで描く
- 8. 合成して測る — 相関が1未満だと、式の上では加重平均より小さくなる
- 9. つまずき実演③:古い調整基準の行が残ったDBは、統計量を壊す
- 10. この数字で分かること・分からないこと/連載15回の締め
- 11. よくある質問(FAQ)
1. この記事のゴールと、ここでいう「リスク」の意味
本記事は「Python経験者が、投資ポートフォリオを管理・可視化するアプリを作る」連載の第15回、最終回です。第14回で毎日 prices.db に終値が積もるようにしました。その終盤の「ためたデータで分かること・分からないこと」の表には、こう書いてあります。
複数銘柄/答えられること=同じ日付の行が揃っているか/答えられないこと=銘柄同士の関係(第15回)
その「銘柄同士の関係」を数値にするのが今回です。作るのは1本のCLIスクリプト、出るのは端末の表とPNG2枚。画面は作りません(第13回でやりました)。
本記事でいうリスク=過去の値動きが、どれだけ散らばっていたかを数値にすること。それだけです。
- 損をする危険度の評価でも、銘柄の良し悪しの判定でもありません。本記事やシリーズ一覧の「定量評価」も、散らばりを数値にすることだけを指します——安全度の格付けでも、銘柄の評価でもありません
- 出るのは「1日ごとの変化率が、平均からどれくらいばらついていたか」という、ただの計算結果です。将来どうなるかも、どの銘柄をどれだけ持つとよいかも出しません。配分を探す最適化も実装しません(理由は11章)
- 当サイトは投資助言業(金融商品取引業)の登録をしておらず、個別銘柄の推奨や売買タイミングの助言は行いません
用語をもう2つ。本記事の「分散」は統計量の variance(標準偏差の2乗)で、「分散投資」の意味では使いません(配分の偏りは第7回の円グラフが担当)。「リターン」はすべて日次リターン(前日比の変化率)で、第4回の「保有期間の金額のリターン」とは別物です。
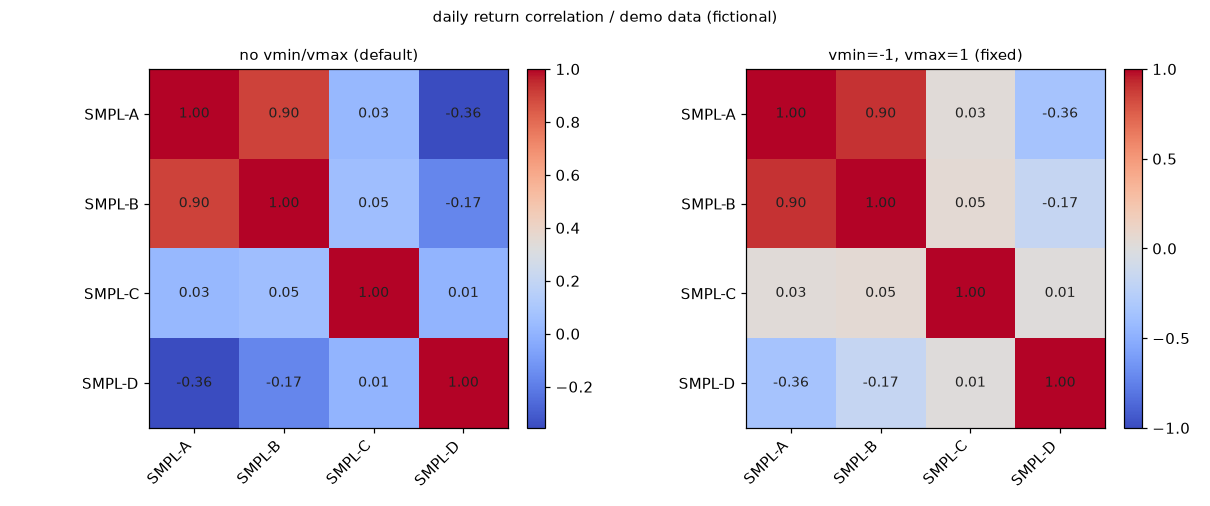
掲載した数値・出力・図はすべて実際に実行して採取しました。内訳は2つ。配布コード portfolio_risk.py の出力そのもの=3・7・8・9章の表と図。確認用に書いた短いスクリプトの出力=2章の DELETE、4章の pct_change 検証、5章・6章の比較と表、7章のRGB値(3章の dropna() との対比、8章の A・A2 行と ddof を揃えない比較も後者=配布コードには入っていません)。入力はシードを固定した架空データ(SMPL-A〜SMPL-E)だけです。実在の銘柄の標準偏差や相関係数は1つも出てきません。このスクリプトは通信を1回も行いません。両OSで数値も図も一致しています(版は冒頭と末尾の注記に)。
2. 入力をそろえる — 貯めたDBを「日付 × 銘柄」の表にする
統計量を出す前に、縦持ち(1行=1銘柄1日)を横持ち(行=日付・列=銘柄)に変えるのが最初の仕事。第14回の prices テーブルは PRIMARY KEY (code, date) の縦持ちなので、pivot() を1回かけます。
uri = db_path.resolve().as_uri() + "?mode=ro"      # file:///…/prices.db?mode=ro
with sqlite3.connect(uri, uri=True) as conn:
    df = pd.read_sql_query(
        "SELECT code, date, close FROM prices ORDER BY date, code", conn)

df["date"] = pd.to_datetime(df["date"])
wide = df.pivot(index="date", columns="code", values="close").sort_index()
mode=ro が今回の約束です。接続URIに付けると、書き込もうとした時点でエラーになります。DELETE を投げると、こうなります。
SELECT count(*) = 1000
DELETE -> OperationalError: attempt to write a readonly database「他人のDBに書き込まない」は第9回から続く約束です。第9回は書き込み先を --demo 用の別DBに分ける運用で守り、それをコメントではなく接続の仕方で守る形にしたのが第12回・第13回。第8回の dividends.db、第11回の perks.db には接続もしません。
第14回をやっていなくても動く入口(--csv と --demo)
DBが無い読者のために、入力は3通りです。
| 指定 | 読むもの | 通信 |
|---|---|---|
--db prices.db | 第14回で貯めたSQLite(読み取り専用) | なし |
--csv prices.csv | date,code,close の3列CSV | なし |
--demo | その場で生成する架空データ250営業日×4銘柄 | なし |
第6回が build_value_history() に渡している終値の表(make_price_history() の戻り値)も、date,code,close の3列に直せば --csv で読めます。戻り値の評価額の表は使いません——売買による数量の増減が「値動き」に混ざり、9章と同じ壊れ方をします。
本記事の出力はすべて --demo です。乱数は default_rng(42) で固定。同じ版のNumPyなら何度実行しても同じ値が出ます(版が変わると乱数列そのものが変わることがあります——第6回と同じ注意)。自分のデータに差し替えるなら --demo --write-csv prices.csv で雛形を書き出せます。
python portfolio_risk.py --demo完成版はportfolio_risk.py(1ファイル・依存は pandas / NumPy / matplotlib の3つだけ)。--weights に既定値は持たせていません(「この配分が標準」に見えるため・8章)。
3. つまずき実演①:dropna() で7割の日が消え、相関が 1.00 になった
毎日貯めたDBは、銘柄ごとに行数が揃いません。途中から足した銘柄、PCを落としていた日、取りこぼした日が、横持ちの表に穴として現れます。--demo --ragged はその状態の再現です(B=後半100日だけ、C=7日おきに欠け、E=3日ぶんだけ)。
python portfolio_risk.py --demo --ragged
== 1. 銘柄ごとの散らばり(単純リターン・年率は252営業日の仮定)==
         本数  std(ddof=1)  std(ddof=0)  年率%(ddof=1)  年率%(ddof=0)
SMPL-A  249     0.014379     0.014350      22.8252      22.7793
SMPL-B   99     0.012348     0.012286      19.6019      19.5026
SMPL-C  178     0.020630     0.020572      32.7495      32.6574
SMPL-D  249     0.018363     0.018326      29.1503      29.0917
SMPL-E 2 0.010572 0.007475 16.7819 11.8666いちばん下の行が問題です。2日ぶんのデータから「年率16.78%」が出ます。計算は正しく、間違っているのは本数を見ずにこの数字を読むこと。だから本ツールは「本数」の列を左端に置いています。
corr() はペアごとに計算する(そして重なり2日で ±1.00 になる)
DataFrame.corr の説明文は「Compute pairwise correlation of columns, excluding NA/null values」(公式リファレンス・2026年9月16日確認)。行を落とすのではなく、ペアごとに「両方ある日」だけを使います。min_periods の既定は 1——1日でも重なれば計算します。
まず --min-periods 1(pandas の既定と同じ)で、止めずに出してみましょう。
python portfolio_risk.py --demo --ragged --min-periods 1
== 3. 相関行列(pearson・min_periods=1)==
        SMPL-A  SMPL-B  SMPL-C  SMPL-D  SMPL-E
SMPL-A  1.0000  0.8917  0.0060 -0.3557     1.0
SMPL-B  0.8917  1.0000 -0.0650 -0.1350     NaN
SMPL-C  0.0060 -0.0650  1.0000  0.0364     1.0
SMPL-D -0.3557 -0.1350  0.0364  1.0000    -1.0
SMPL-E  1.0000     NaN  1.0000 -1.0000     1.0
SMPL-E の行が 1.00 と −1.00 で埋まりました。日次リターンが2本しかない相手との相関は、必ず ±1.00 になります(2点は必ず直線に乗ります)。貯め始めたばかりの銘柄を1つ混ぜるだけで、行列は「きれいに連動している」ように見えます。
だから本ツールは重なり日数の表を相関行列とセットで出し、--min-periods(既定20)で足りないペアを NaN にします。
== 2. ペアごとの重なり日数(この日数で相関が計算されています)==
        SMPL-A  SMPL-B  SMPL-C  SMPL-D  SMPL-E
SMPL-A     249      99     178     249       2
SMPL-B      99      99      71      99       0
SMPL-C     178      71     178     178       2
SMPL-D     249      99     178     249       2
SMPL-E       2       0       2       2       2

== 3. 相関行列(pearson・min_periods=20)==   ← SMPL-E の行・列はすべて NaN になる
  ※ NaN のペアは重なりが 20 日未満です(計算していません)
第14回の --demo で作ったDBは30営業日ぶん(日次リターン29本)なので、--min-periods 30 では全部 NaN。故障ではなく設計どおりです。
dropna() は結果の値まで変える
「揃っていないなら揃えればいい」と dropna(how="any") を掛けると、1銘柄でも短いと全滅します。上の5銘柄では残り0行、SMPL-E を外しても249行 → 71行です。
pairwise の A-C      = 0.005964
dropna 後(4銘柄)の A-C = -0.140662  (71日で計算)
同じ2銘柄の相関が、ほぼ0から −0.14 に変わりました。どちらかが間違っているのではなく、計算に使った日が違うだけです。標準偏差も同じで、dropna() 後の SMPL-A は年率23.9077%(71日)、全249日なら22.8252%。相関や標準偏差を人に見せるときは、値だけでなく「どの日を何日ぶん使ったか」を必ず添える——この章の結論です。
4. 日次リターンにする — 単純・対数と、pandas 3.0 の pct_change
終値の表ができたら、日次リターン(前日比の変化率)に変換します。第6回で「金額ではなく比率で見る必要があります」と書いた、その比率がこれです。
simple = px.pct_change(fill_method=None)   # 単純リターン (P_t / P_t-1) - 1
log_r  = np.log(px).diff()                 # 対数リターン log(P_t) - log(P_t-1)
架空データ250営業日で両方を出し、突き合わせました。
max|差| = 9.230e-04   mean|差| = 1.029e-04   |日次リターン|の最大 = 0.04358
年率SD  単純 = 22.8252%   対数 = 22.7879%   差 = 0.037 %pt
対数リターンの和 = 0.14828186   log(末/初) = 0.14828186   ← 一致する
単純リターンの和 = 0.17391004 (1+r).prod()-1 = 0.15983976 末/初-1 = 0.15983976日次の水準(1日1〜4%)なら差は小数第4位で、年率の標準偏差でも0.037%ptしか変わりません。違うのはつなぎ方——対数リターンは足し算で期間をつなげ(和が log(末/初) に一致)、単純リターンは (1+r) の積になります。本ツールの既定は単純リターン、--log-return で切り替えます。
pandas 3.0 の pct_change() は、もう欠損を埋めない
pandas 3.0(2026年1月21日リリース)で pct_change() の引数が整理されました。whatsnew の「Removal of prior version deprecations/changes」には「Removed argument limit from DataFrame.pct_change(), Series.pct_change() …; the argument method must be set to None and will be removed in a future version of pandas」とあります(pandas 3.0.0 whatsnew・2026年9月16日確認)。この method は、実シグネチャの fill_method の誤記です(inspect.signature で見ても method という引数はありません)。本記事は fill_method と書きます。欠損を2つ含む6行で確かめます。
p.pct_change() [引数なし]:
2025-01-07    0.010000
2025-01-08         NaN
2025-01-09         NaN
2025-01-10         NaN      ← 穴の直後の日も NaN(前埋めしない)
2025-01-13   -0.009615
  警告: []                   ← 警告は0件
fill_method=None と同じ結果か: True

p.pct_change(fill_method='ffill') -> ValueError: fill_method must be None; got fill_method='ffill'.
p.pct_change(limit=1) -> TypeError: NDFrame.shift() got an unexpected keyword argument 'limit'limit= のエラーは shift() の名前で出るlimit を渡したときのメッセージは NDFrame.shift() got an unexpected keyword argument 'limit'——「limit は削除されました」とは一言も言いません。残った **kwargs が shift() に流れるためです。2.x 時代のコードを写して shift の名前が出てきたら、この件です(エラー文の読み方はPythonエラー一覧22種と直し方へ)。
3.0 では引数なしでも fill_method=None と同じで、警告も出ません(上の実測)。それでも明示するのは、「意図的に埋めていない」とコードを読む人へ伝えるためです。
埋めたい場合、公式は「explicitly call e.g. DataFrame.ffill() … before calling pct_change instead」(2.1.0 whatsnew)と案内しています。ただし前埋めすると、上の6行では 0.000000(変化0の日)が2日でき、101→104 の変化が 0.029703 として1日に押し込まれました。穴の数だけ「動かなかった日」が水増しされ、標準偏差は小さく出ます。本記事は埋めず、NaN のまま corr() のペアごと計算に任せ、足りないペアを min_periods で落とします(3章の方針)。
5. つまずき実演②:同じデータなのに pandas と NumPy で標準偏差が違う
同じ249本の日次リターンを、6通りの書き方で測ります。
s.std()            [pandas既定 ddof=1] = 0.01437854   年率 = 22.8252%
s.std(ddof=0)                         = 0.01434963   年率 = 22.7793%
np.std(arr)        [numpy既定 ddof=0]  = 0.01434963   年率 = 22.7793%
np.std(arr, ddof=1)                   = 0.01437854   年率 = 22.8252%
statistics.stdev   [標本 N-1]          = 0.01437854
statistics.pstdev  [母集団 N]           = 0.01434963
n = 249 比 = 1.00201410 理論 sqrt(n/(n-1)) = 1.002014106つの呼び方が、2つの値に割れます。原因は ddof(Delta Degrees of Freedom)で、割る数が N - ddof になります。pandas は「Normalized by N-1 by default.」(Series.std)、NumPy は「By default ddof is zero.」(numpy.std)——同じ Python のデータ分析の道具なのに、既定が逆です。標準ライブラリの statistics は関数名で区別します(上の出力)。
どちらかが間違いではありません。手元のデータを「全部」とみなすなら N、「たまたま取れた一部」とみなすなら N−1という立場の違いです。第4回で「リターン率の分母は『自分で決める』もの」と書いたのと同じで、正しさを探すより、どちらを使ったかを書くほうが実用的です。
差が効くのは、本数が少ないとき
比は √(n/(n−1)) なので、本数が増えるほど差は縮みます。年率換算した後の差(%pt)で並べます。
| 日次リターンの本数 | 年率(ddof=1) | 年率(ddof=0) | 差 |
|---|---|---|---|
| 249本(約1年) | 22.8252% | 22.7793% | 0.0459 %pt |
| 29本(30営業日ぶん) | 20.2398% | 19.8878% | 0.3520 %pt |
第14回の --demo をそのまま読んだ読者がいちばん差を踏みます。√252 を掛けても比率は変わりません(定数倍なので)。変わるのは差の大きさ——日次の0.0029%ptが、年率では0.046%ptに見えます。
相関には出ない。共分散には出る
相関係数は ddof の影響を受けません。相関は「共分散 ÷(標準偏差×標準偏差)」なので、分母と分子の N−ddof が約分されるからです。DataFrame.corr には ddof 引数自体がありません。一方 DataFrame.cov は ddof=1 を持ち、値が変わります。
NaN を落とした表 cov(ddof=1) A-B = 1.6135658684e-04
NaN を落とした表 cov(ddof=0) A-B = 1.6070856842e-04   比 = 1.00403226  (249/248 = 1.00403226)
NaN を含む表   cov(ddof=1) A-B = 1.6135658684e-04
NaN を含む表 cov(ddof=0) A-B = 1.6135658684e-04 比 = 1.00000000 ← 効いていないcov(ddof=0) は、表に NaN が1つでもあると黙って無視される公式リファレンスの ddof の説明には「This argument is applicable only when no nan is in the dataframe.」(DataFrame.cov)とあります。pct_change() の結果は先頭行が必ず NaN なので、そのまま cov(ddof=0) を呼んでもエラーも警告も出ないまま ddof=1 の値が返ります(上の実測)。8章の合成は dropna() してから計算し、使った行数を表示します。
6. 年率に直す(年率ボラティリティ)— なぜ √252 なのか、252 はどこから来たのか
日次の標準偏差 0.014379 では大きさがつかめないので、年率に直すのが慣例です(この年率化した標準偏差が、一般に「年率ボラティリティ」と呼ばれる数値です)。掛けるのは np.sqrt(252)。なぜ 252 ではなく √252 なのでしょうか。
理由は「分散は足せるが、標準偏差は足せない」から。互いに独立な確率変数の和の分散は、分散の和になります(「X と Y が独立のとき,X + Y の分散は,V(X + Y) = V(X) + V(Y) となる」=大阪大学・谷崎久志「基礎計量経済学」付録)。日次リターンが独立で同じ分布に従うと仮定すれば、1年分の分散は日次の分散を営業日数だけ足したもの。日本取引所グループ(JPX)の資料が、その式を書いています。
σ²年率=σ²日率+σ²日率+σ²日率+…=245σ²日率(245日分のσ²日率の合計)このため、年率換算されたボラティリティー(σ年率)を日率(σ日率)に直すためには年間の営業日数(=245日ほど)の平方根(15.65)、すなわちおよそ16で割り算するとよいことが知られています(JPX「日経平均ボラティリティー・インデックス先物取引の利用のコツ」p.6・2026年9月16日確認)
分散に営業日数を掛け、標準偏差に直すために平方根を取る。だから √ が付きます。裏を返すと、日次リターンに連動の癖(自己相関)があれば、この換算は成り立ちません。√252 は事実ではなく仮定を置いた計算です。
252 も仮定値。日本の一次資料は 245〜250 を使っている
252 という数字自体にも、公表された統一基準はありません。上のJPX資料は 245、野村證券の用語解説は「1年=250(営業日)…の各250、52、12の平方根を掛けた値が年率換算値になる」(証券用語解説集)と 250。252 は主に米国株の営業日数に由来する慣行です。実際の営業日数も数えました(内閣府の国民の祝日CSVとJPXの休業日ルール=土日・祝日・12月31日〜1月3日から計算。2026年はJPXの休業日一覧と一致)。
| 年 | 2023 | 2024 | 2025 | 2026 |
|---|---|---|---|---|
| 営業日(計算値) | 246 | 245 | 243 | 242 |
| 252 との差 | −6 | −7 | −9 | −10 |
同じ日次標準偏差を、営業日数の仮定だけ変えて年率にするとこうなります。
  252 営業日 -> 年率 22.8252%     245 営業日 -> 年率 22.5060%
  250 営業日 -> 年率 22.7345%     243 営業日 -> 年率 22.4139%
252 と 243 の差は 0.41%pt。5章の ddof の差(0.046%pt)より1桁大きいのに、こちらは意識されないまま数字が出回ります。本ツールは --days-per-year を引数にし、出力にも「年率は252営業日の仮定」と毎回書きます。
これは「過去のこの期間の日次の散らばりを、252営業日ぶん積み上げたと仮定して1年の単位に直した数値」です。「1年後に ±22.8% 動く」という予測ではありませんし、来年も同じ散らばりになるという意味でもありません。仮定(日次リターンが独立・営業日数252)を変えれば、上の表のように数字自体が変わります。
7. 相関行列のヒートマップを、seaborn なしで matplotlib(imshow)だけで描く
相関行列は表でも読めますが、銘柄が増えると図のほうが早い。検索すると seaborn.heatmap の例ばかり出てきますが、本記事はmatplotlib の imshow だけで描きます。依存を増やさないためで、seaborn を否定しているわけではありません(用途の違い。位置づけはPythonライブラリ一覧に)。
im = ax.imshow(corr.to_numpy(), cmap="coolwarm", vmin=-1, vmax=1)
ax.set_xticks(range(len(corr.columns)), corr.columns, rotation=45, ha="right")
ax.set_yticks(range(len(corr.index)), corr.index)
for i in range(corr.shape[0]):
    for j in range(corr.shape[1]):
        v = corr.to_numpy()[i, j]
        ax.text(j, i, "nan" if np.isnan(v) else f"{v:.2f}", ha="center", va="center")
cb = ax.figure.colorbar(im, ax=ax); cb.set_ticks([-1, -0.5, 0, 0.5, 1])
この図で本当に大事な引数は vmin=-1, vmax=1 の2つです。公式リファレンスにこうあります——「By default, the colormap covers the complete value range of the supplied data.」(Axes.imshow)。つまり指定しないと、色の両端がそのデータの最小値と最大値に張り付きます。1章の図の左右は、同じ数値でこうなっています。
相関行列の min/max = -0.355656 1.000000
vmin/vmax なし  get_clim() = (-0.3557, 1.0000)   相関0.03 のセルの色 RGB = (0.592, 0.723, 0.999)  ← 青
vmin=-1,vmax=1 get_clim() = (-1.0000, 1.0000) 相関0.03 のセルの色 RGB = (0.880, 0.858, 0.846) ← 灰色ほとんど連動していない(0.03)ペアが、真っ青に塗られます。色だけ見た人は「逆方向に動いている」と読むでしょう。−1から1に固定すれば coolwarm の中央(灰色)が相関0に来るので、TwoSlopeNorm のような道具も要りません。相関行列は値の範囲が最初から −1〜1 と決まっているので、固定しない理由がありません。
図の中の文字は英字だけです。matplotlib の同梱フォントに日本語が無く、そのままでは□(豆腐)になるからです(対処は第5回の7章)。描画は matplotlib.use("Agg") 固定で plt.show() を呼びません(画面の無い環境でも同じPNGが出ます)。
1章の2枚並べはこのオプションで再現できます(--heatmap なら固定版1枚)。
python portfolio_risk.py --demo --heatmap-compare heat.png # 1210×506 のPNGが1枚出る8. 合成して測る — 相関が1未満だと、式の上では加重平均より小さくなる
銘柄ごとの標準偏差と相関が出たら、「その配分で持っていたら、全体の日次リターンはどれくらい散らばっていたか」を計算できます。共分散行列 cov と配分 w の1行です。
used = ret.dropna()                       # 全銘柄そろった日だけ(行数を表示する)
cov = used.cov(ddof=1)
sd_matrix = np.sqrt(w @ cov.to_numpy() @ w)        # 行列の式
sd_series = (used.to_numpy() @ w).std(ddof=1)      # 合成した系列から直接
この2つは同じものを別の順序で計算しているので、一致するはずです。実測では差は 1e-17 未満(Windows で 1.73e-18・Linux Mint で 3.47e-18=浮動小数の丸め)。ただしddof を揃えないと合いません。
sqrt(w@cov(ddof=1)@w) = 0.0130733719
(ret@w).std(ddof=0)   = 0.0130470937
差 = 2.63e-05 (年率で 0.0417 %pt)「検算したのに合わない」の正体はだいたいこれです(5章)。
相関によって、合成の結果は変わる
穴の無いほうの架空データ(--demo・249本そろい)で、配分 0.5 / 0.5 のペアを3組と、3銘柄の例を並べます。「加重平均SD」は各銘柄の標準偏差を配分で加重平均しただけの、比較用の基準です。3章の相関(A・B=0.8917)と数字が違うのは、3章が --demo --ragged(Bは99本だけ)なのに対し、ここは全249本を使っているからです。
2銘柄なら、式はこう展開できます。σ_mix² = w₁²σ₁² + w₂²σ₂² + 2w₁w₂ρσ₁σ₂。相関 ρ が出てくるのは右端の項だけなので、ρ が小さいほど第3項が小さくなり、平方根を取った合成SDも小さくなります。
| 組み合わせ(配分) | 相関 | 合成SD | 加重平均SD | 合成 ÷ 加重平均 |
|---|---|---|---|---|
| A・A2(0.5/0.5)※A2はAの2倍の人工データ(配布コードには含みません) | 1.0000 | 0.0215678 | 0.0215678 | 1.000000 |
| A・B(0.5/0.5) | 0.9037 | 0.0130734 | 0.0133981 | 0.975766 |
| A・C(0.5/0.5) | 0.0255 | 0.0124242 | 0.0171404 | 0.724846 |
| A・D(0.5/0.5) | −0.3557 | 0.0094357 | 0.0163707 | 0.576377 |
| A・B・C(0.5/0.3/0.2) | — | 0.0115264 | 0.0148950 | 0.773846 |
読み取れるのは式の性質です。相関がちょうど1のとき、合成SDは加重平均SDと一致します(比 1.000000)。1より小さいと左辺のほうが小さくなります。ただし相関 0.90 の組では比 0.976——2.4%しか変わりません。同じ表の中に、ほとんど変わらない組み合わせも並んでいます。
上の比が1より小さくなるのは、共分散行列を使った計算の性質です。将来もそうなるという保証ではありませんし、「相関の低い銘柄を組み合わせましょう」という提案でもありません。過去に低かった相関が続くかどうかは、この計算では分かりません(3章のとおり、期間を変えるだけで相関の値は動きます)。本記事は配分を探す最適化を実装しません(理由は11章のFAQ)。
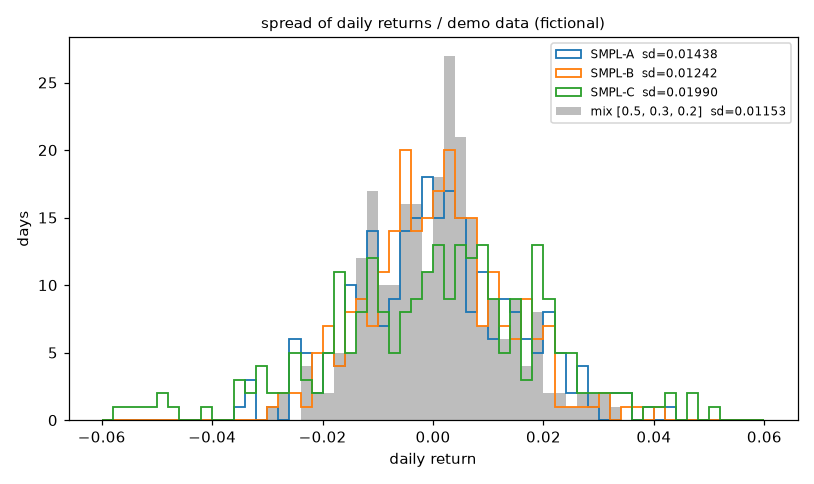
合成の数値と分布図は --weights を渡したときだけ出ます(上の表は、組み合わせを変えて実行し並べ直したもの)。
python portfolio_risk.py --demo --codes SMPL-A,SMPL-B,SMPL-C --weights 0.5,0.3,0.2 --spread spread.png--weights は必須の引数で、既定値を持ちません。配分を決めるのは読者であって、ツールではないからです。
9. つまずき実演③:古い調整基準の行が残ったDBは、統計量を壊す
最後は貯めたデータでしか起きない問題です。株価データの「調整後終値」は、株式分割や分配金があるたびに、それより前の日の値まで遡って書き換わります。第14回が使った yfinance も、現行版(1.4.1 と 1.7.0 の2版で実測)の history()・download() はいずれも auto_adjust=True が既定です(yfinance の history.py(main ブランチ)の引数既定値で確認・2026年9月16日/download() 側は multi.py)。
ところが第14回の運用は毎回「直近5営業日」を取り直して UPSERT する設計でした。取り直した5行だけが新しい基準に入れ替わり、それより前の行は取得当時の基準のまま残ります。1つのDBの中で基準が混ざるわけです。
python portfolio_risk.py --demo-split
[再現実験] 架空の40営業日・2025-06-30 に 1:2 の株式分割があったと仮定
  DBに残った値      : 1842.0 -> 899.2   日次リターン -0.5118
  取り直した正しい値: 921.0 -> 899.2   日次リターン -0.0237
  |日次リターン|>20% の件数  DB 1 件 / 正しい系列 0 件
  年率SD  DB 129.94%  /  正しい系列 17.01%
[参考] 分配金 1.87% ぶんの遡及調整だけでも
  境界日の日次リターン -0.0420(正しくは -0.0237)
  年率SD  DB 18.85%  /  正しい系列 17.01%
境目に −51% という存在しない日次リターンが1本生まれ、年率の標準偏差が 17% から 130% に飛びました。同じ1本が相関の計算にも入るので、相関行列も一緒に動きます。怖いのは下の参考のほうで、分配金ぶん(2%弱)の調整では年率が2%ptずれるだけ——表を眺めても気づけません。
対策は2つ。①1日の変化率が極端な行を機械的に拾う——本ツールは |日次リターン| > 20%(--jump で変更可)の行を一覧表示します。②分割・分配金があった銘柄は全期間を取り直す——第14回の stock_daily_fetch.py の --period(既定 5d)を --period 1y のように長くすれば、その範囲が新しい基準で上書きされます。
上の数値はすべて架空データによる再現実験です。実在の銘柄で分割前後の統計量を計算して見せることはしません(1章の方針どおりです)。「調整後の値は遡って変わる」という仕組み自体は yfinance の既定動作として確認できますが、あなたのDBで何%ずれるかは、あなたのDBを調べないと分かりません。
10. この数字で分かること・分からないこと/連載15回の締め
ここまでの出力を仕分けます。右の列が、この道具の限界です。
| 出した数値 | 答えられること | 答えられないこと |
|---|---|---|
| 日次リターンの標準偏差 | その期間、1日あたりの変化率がどれだけ散らばっていたか | これから散らばるかどうか/その銘柄の良し悪し |
| 年率換算した値 | 日次の散らばりを共通の単位に直した数値(仮定つき) | 1年後にいくら動くか |
| 相関係数 | その重なり日数のあいだ、2銘柄が同じ方向に動いた度合い | 因果関係/次の期間も同じ相関か |
| 合成の標準偏差 | その配分だったときの、過去の散らばり | どの配分がよいか(本記事は探しません) |
やらなかったことも並べます。効率的フロンティア・最小分散の配分探索・モンテカルロによる将来の分布・シャープレシオ・ベータ・VaR——いずれも実装していません。「良し悪しの判定」や「どれをどれだけ持つか」の出力に直結するからです。
この記事で踏んだ罠は、ddof・pct_change の欠損の扱い・pivot と NaN・ペアごとの計算——投資の知識ではなく pandas と NumPy のデータモデルの話ばかりです。ここを通しで固めるならPythonによるデータ分析入門 第3版(pandas の開発者 Wes McKinney 本人の著書・全612ページ)。当サイトの参考書ランキングでは総合5位。リンク先で対象レベルと出版社の公式ページを確認できます。リンク先は当サイトの書籍紹介ページで、アフィリエイト広告を含みます。先に断っておくと、同書は pandas 2.0 対応(2023年8月刊)で、4章の pandas 3.0 の変更そのものは載っていません。効くのはいま挙げたデータモデル側——版が変わっても動かないほうです。ここを押さえると、次に同じズレが出たとき本数・ddof・欠損のどれが原因かを自分で切り分けられるようになります。同書はプログラミングの技術書であり、特定の銘柄や売買手法を勧めるものではありません。
連載15回でやってきたこと
| 回 | やったこと | 出したもの |
|---|---|---|
| 第1〜2回 | 株価を取る/取っていい場所を調べる | 終値の表 |
| 第3〜4回 | 証券会社のCSVを読み、損益を計算する | 取得単価・評価額 |
| 第5〜7回 | ローソク足・Plotly・円グラフ | PNGとHTMLの図 |
| 第8〜11回 | 配当・カレンダー・利回り・優待を記録(第10回だけCSV) | dividends.db・perks.db |
| 第12〜14回 | NumPyの地雷・1画面に束ねる・毎日走らせる | 毎日育つ prices.db |
| 第15回(本記事) | 貯まったデータから統計量を出す | 標準偏差・相関行列 |
15本を通して1本も出していないのが「買うべき銘柄」と「売買のタイミング」です。
本連載は「自分の資産を自分で管理・可視化するツールを、Pythonの学習題材として自作する」ことが目的です。特定銘柄の売買や投資手法を勧めるものではありません。本記事に登場するサンプルデータ(SMPL-A〜SMPL-E)はすべて架空の値で、統計量も架空データから計算したものです。金融商品取引法38条2号は不確実な事項について断定的判断を提供することを禁じており、金融庁の監督指針も「有価証券等の価格、数値、対価の額の動向を断定的に表現したり、確実に利益を得られるように誤解させて、投資意欲を不当に刺激するような表示」を戒めています(金融商品取引業者等向けの総合的な監督指針)。当サイトは投資助言業(金融商品取引業)の登録を行っておらず、個別銘柄の推奨・売買タイミングの助言・税務相談には応じられません。投資判断はご自身の責任で(詳細は免責事項)。
11. よくある質問(FAQ)
Q. 第14回をやっていないのですが、試せますか?
試せます。--demo を付けると架空データ250営業日×4銘柄をその場で生成します(通信なし)。図と再現実験は、オプションを足したときだけ出ます。
--demo= 4つの表(散らばり・重なり日数・相関・共分散)--heatmap-compare heat.png= 1章のヒートマップ(7章)--weights+--spread spread.png= 8章の分布図(8章)--demo-split= 9章の再現実験
自分のデータは date,code,close の3列CSVを --csv で(雛形は --demo --write-csv prices.csv)。
Q. 最適な配分は求められますか?
求めません。本記事のツールに配分を探す機能はありません。金融商品取引法は「投資判断」を「投資の対象となる有価証券の種類、銘柄、数及び価格並びに売買の別、方法及び時期についての判断」(ほかに、行うべきデリバティブ取引の内容および時期についての判断も含みます)と定義しています(2条8項11号ロの括弧書き)。配分の最適化は「どの銘柄をどれだけ(数)持つか」の判断に踏み込むことになるため、当サイトは統計量を出すところで止めます。
Q. std() の数字が、他のサイトの例と合いません。
ddof を確認してください。pandas の std() は既定 ddof=1(N−1で割る)、NumPy の np.std() は既定 ddof=0(Nで割る)で、同じデータから2つの値が出ます(5章)。年率換算の営業日数(252 / 250 / 245)でも動きます(6章)。
Q. 252 と 250、どちらが正しいのですか?
公表された統一基準は確認できていません。JPXの資料は245、野村證券の用語解説は250、Python記事でよく見る252は主に米国株由来の慣行です(実際の営業日は計算値で2023年246日・2025年243日)。使った値を書いてください。本ツールは --days-per-year で変えられます。
Q. 相関行列が 1.00 だらけになります。
ペアごとの重なり日数を見てください。corr() はペアごとに「両方とも値がある日」だけで計算し、min_periods の既定は1です。重なりが2日しかないペアは必ず ±1.00 になります。本ツールは重なり日数の表を必ず一緒に出し、--min-periods(既定20)で落とします(3章)。
Q. モンテカルロで将来のばらつきを出せませんか?
本連載では扱いません。「将来こうなる確率」という形の出力は、断定的判断の提供と読まれかねない表現を誘発します。第12回も「乱数は使わないため同じ入力なら同じ結果が出ます」で通しました。本記事の乱数は架空の入力データを作るためだけに使っています。
Q. seaborn を使ってはいけないのですか?
まったく問題ありません。imshow だけで描いたのは、配布コードの依存を3つに抑えるためです。seaborn.heatmap(corr, vmin=-1, vmax=1, annot=True) なら1行で済みます。vmin・vmax を指定する点はどちらでも同じです(7章)。
Q. prices.db は書き換わりますか? 株価はどこから取るのですか?
書き換わりません。DBは file:…?mode=ro で開いており、書き込もうとすると OperationalError: attempt to write a readonly database になります(2章)。株価を取りに行くのは第1回、貯めるのは第14回の担当で、この記事のスクリプトは通信を1回も行いません。
完成版 portfolio_risk.py を保存して --demo → --demo --ragged(3章の再現)→ --db prices.db --min-periods 20(自分のデータ)の順に叩きます。本数の列と重なり日数の表を先に見るのが、この道具の使い方です。
エラーはPythonエラー一覧22種と直し方、全体像は投資×Python シリーズ一覧か新着記事のRSSで追えます。
本記事は、生成AIを活用して下書きし、運営者が確認・編集して公開しています。掲載のコード・出力・図は、冒頭に記した Windows 11 と Linux Mint 22.3(仮想マシン)の2環境(SQLite は 3.49.1 と 3.45.1)で 2026年9月16日に実行して確認し、数値も図も両OSで一致しました。データはすべて架空(SMPL-A〜SMPL-E)で、実在の銘柄の統計量は1つも含みません。本ツールが行うのは過去の値動きの散らばりの計算だけで、資産の査定でも投資判断でもありません。本記事はプログラミングの情報提供が目的で、銘柄の売買・投資手法の推奨でも税務上の助言でもありません。投資判断はご自身の責任で。AIの利用方針は免責事項をご覧ください。